
Robots.txt SEO: cum eviti blocarea paginilor importante
Un fisier robots.txt configurat gresit poate limita accesul crawlerelor la pagini, resurse sau sectiuni care sustin vizibilitatea organica. Acest ghid despre robots.txt SEO explica ce controleaza acest fisier, ce nu poate face, ce pagini merita protejate si cum verifici regulile inainte de publicare. Vei intelege diferenta dintre blocarea crawl-ului si eliminarea din index, precum si modul in care o configuratie corecta sustine traficul relevant, monitorizarea SEO si experienta utilizatorului.
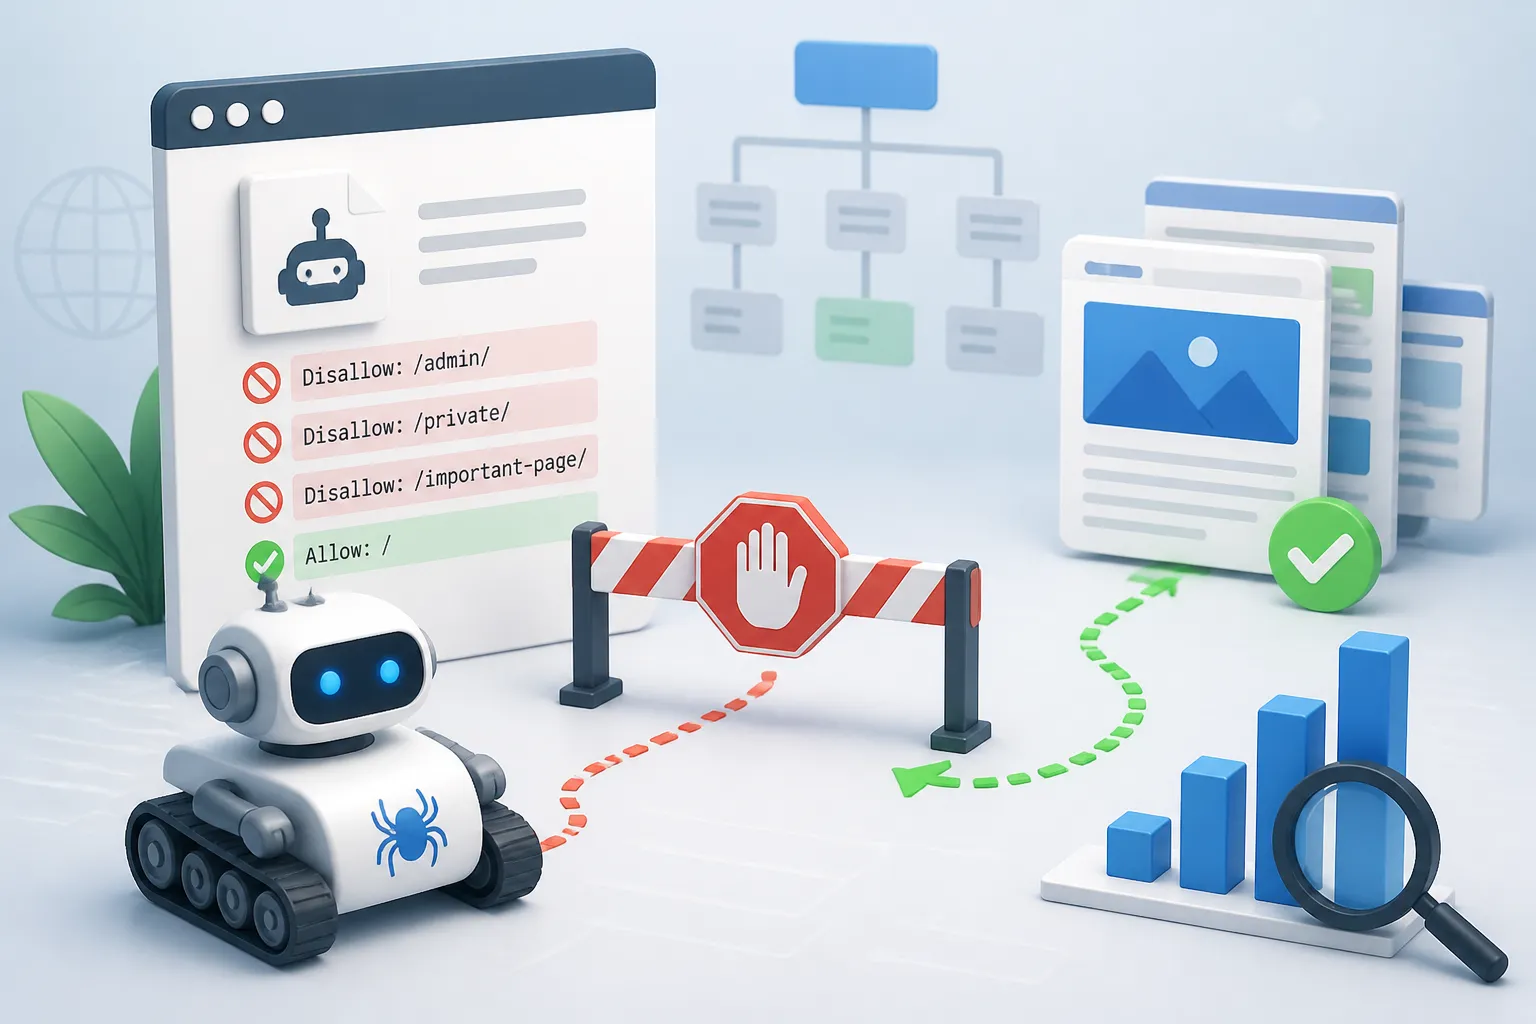
Configuratia robots.txt trebuie verificata in contextul structurii tehnice si al obiectivelor SEO ale website-ului.
Robots.txt SEO inseamna folosirea corecta a fisierului robots.txt pentru a ghida crawlerele motoarelor de cautare fara a restrictiona accidental paginile importante. Fisierul poate reduce accesul la zone fara valoare SEO, dar o regula gresita poate impiedica Google sa acceseze pagini de servicii, categorii, produse, imagini sau fisiere necesare randarii corecte.
Pentru un business, problema nu este doar una tehnica. Daca paginile comerciale nu pot fi explorate sau daca resursele relevante sunt blocate, vizibilitatea organica poate avea de suferit. Efectul final asupra leadurilor sau vanzarilor depinde in continuare de cerere, oferta, calitatea paginii, competitivitate si procesul comercial.
Un audit robots.txt trebuie facut impreuna cu verificarea indexarii, sitemap-ului, regulilor noindex, linkurilor interne si rapoartelor din Google Search Console. Privit separat, fisierul poate crea impresia ca totul este corect, desi accesul crawlerelor la continutul important ramane limitat.
Ce este fisierul robots.txt si ce controleaza in SEO?
Fisierul robots.txt este un document text plasat la nivelul radacinii domeniului, de regula la adresa domeniu.ro/robots.txt. El transmite instructiuni pentru anumite crawlere despre ce directoare, fisiere sau tipuri de URL-uri ar trebui sa nu exploreze.
In practica, regulile sunt construite cu directive precum User-agent, pentru crawlerul vizat, si Disallow, pentru calea care nu trebuie explorata. Poate fi folosita si directiva Allow in situatii specifice. Un fisier robots.txt nu este un instrument de securitate: o pagina blocata poate fi accesata in continuare de utilizatori daca au URL-ul, iar alte sisteme pot ignora instructiunile.
Distinctie importanta: robots.txt controleaza in principal crawl-ul, nu reprezinta o metoda sigura de eliminare a unei pagini din index. Pentru continut care trebuie exclus din rezultatele de cautare, regula potrivita poate fi noindex, daca pagina trebuie sa ramana accesibila crawlerelor.
Ce pagini importante nu ar trebui blocate prin robots.txt?
Nu exista o lista universala, deoarece arhitectura unui website difera de la un business la altul. Totusi, paginile care atrag cautari comerciale sau sustin intelegerea site-ului de catre motoarele de cautare nu ar trebui blocate fara un motiv tehnic clar.
Pentru o firma de servicii, acestea pot fi paginile de servicii, paginile locale, studiile de caz publice si paginile de contact. Pentru un ecommerce, pot include categorii, subcategorii, pagini de produs, filtre care au valoare de cautare si fisiere necesare pentru afisarea corecta a continutului.
Atentie si la resursele CSS, JavaScript sau imagini relevante. Daca acestea sunt restrictionate, un motor de cautare poate avea dificultati in interpretarea structurii si a continutului randat. Aceasta situatie este mai probabila pe website-urile construite cu framework-uri moderne sau cu multe functionalitati bazate pe JavaScript.
Cum functioneaza regulile robots.txt in raport cu Google?
Motoarele de cautare citesc de regula fisierul robots.txt inainte de a explora anumite URL-uri. Totusi, comportamentul final poate depinde de crawler, de formatul regulilor si de accesibilitatea serverului. O eroare de sintaxa, o cale prea generala sau o regula mostenita dupa un redesign poate produce blocaje neintentionate.
De exemplu, o regula care restrictioneaza un director comun poate bloca simultan pagini administrative, URL-uri de test si pagini comerciale daca structura URL-urilor nu a fost planificata atent. In acelasi timp, blocarea unor parametri poate fi utila atunci cand site-ul genereaza multe URL-uri fara valoare, cum ar fi rezultate interne de cautare sau combinatii de filtre repetitive.
Exemplu practic
Un magazin online poate dori sa reduca explorarea URL-urilor rezultate din filtre foarte numeroase. Inainte de a bloca un tip de parametru, echipa trebuie sa verifice daca acele pagini aduc trafic organic relevant, au linkuri interne utile sau raspund unei intentii reale de cautare.
Cum verifici daca robots.txt blocheaza pagini utile?
Verificarea trebuie inceputa cu URL-urile care conteaza comercial: pagini de servicii, produse, categorii, landing pages organice si pagini locale. Compara lista acestora cu regulile din fisier si cu datele disponibile in Google Search Console. O scadere a paginilor indexate sau a clickurilor organice nu demonstreaza singura o problema de robots.txt, dar merita investigata.
Este util sa folosesti si o unealta de crawling SEO pentru a vedea ce URL-uri sunt restrictionate, ce raspunsuri ofera serverul si daca paginile importante sunt descoperite prin linkuri interne. Verificarea trebuie repetata dupa migrari, schimbari de platforma, lansari de functii noi sau interventii ale mai multor echipe tehnice.
- Testeaza URL-urile comerciale prioritare.
- Verifica accesul la resursele de randare.
- Compara regulile cu sitemap-ul XML.
- Analizeaza rapoartele de indexare.
- Documenteaza fiecare modificare tehnica.
Care sunt cele mai frecvente greseli de robots.txt SEO?
Cea mai riscanta greseala este blocarea intregului site printr-o regula generala folosita temporar pe un mediu de dezvoltare si lasata activa dupa lansare. O alta problema apare cand regulile sunt copiate dintr-un proiect vechi, fara a fi adaptate structurii actuale de URL-uri.
Unele companii blocheaza pagini pe care nu vor sa le vada in Google, dar fara sa inteleaga diferenta dintre blocarea explorarii si noindex. Altele permit crawlerelor accesul la mii de URL-uri tehnice, consumand inutil resursele de explorare si complicand analiza performantei organice.
- Blocarea accidentala a intregului domeniu.
- Restrictionarea paginilor de produs sau serviciu.
- Folosirea robots.txt in loc de noindex.
- Blocarea fisierelor CSS si JavaScript utile.
- Ignorarea regulilor dupa un redesign.
Regula de decizie: nu bloca un tip de URL doar pentru ca pare tehnic sau repetitiv. Verifica mai intai rolul sau in crawl, indexare, navigare, cautari relevante si conversii asistate.
Robots.txt, noindex si canonical: ce alegi pentru fiecare situatie?
Robots.txt, noindex si canonical rezolva probleme diferite. Robots.txt este folosit pentru a limita explorarea anumitor zone. Meta robots noindex comunica faptul ca o pagina accesibila crawlerului nu ar trebui afisata in index. Canonical indica versiunea preferata dintre pagini foarte similare sau duplicate.
Daca o pagina trebuie pastrata pentru utilizatori, dar nu are valoare in rezultatele organice, noindex poate fi mai potrivit decat robots.txt. Daca ai variante similare ale aceleiasi pagini, de exemplu URL-uri cu parametri de campanie sau sortare, canonical poate ajuta la clarificarea versiunii principale. Alegerea depinde de scop, nu de o regula automata.
Este recomandat ca regulile sa fie coerente. O pagina blocata prin robots.txt nu mai poate transmite usor semnalul noindex, deoarece crawlerul nu ii poate accesa continutul. De aceea, implementarea trebuie gandita la nivelul intregii strategii tehnice SEO.
Cand este util sa limitezi crawl-ul prin robots.txt?
Limitarea crawl-ului este utila atunci cand exista zone care nu trebuie explorate si care nu contribuie la vizibilitatea organica. Exemplele pot include anumite pagini de administrare, medii de test expuse accidental, rezultate de cautare interna, URL-uri generate de functii temporare sau sectiuni cu date private care nu ar trebui servite public.
Nu orice website are nevoie de reguli complexe. Un site de prezentare simplu, cu putine pagini, poate avea un fisier minimal sau chiar niciun set extins de restrictii. In schimb, un ecommerce cu filtre, sortari, conturi de utilizator si mii de URL-uri dinamice poate necesita o planificare mai atenta.
Recomandare de implementare
Inainte de publicare, pastreaza o lista cu URL-urile care trebuie sa ramana accesibile crawlerelor si valideaza fiecare regula pe un mediu controlat. Dupa lansare, urmareste indexarea, erorile de crawl si evolutia paginilor prioritare.
Ce criterii de business conteaza inainte de modificarea fisierului?
O schimbare de robots.txt trebuie corelata cu obiectivul de business, nu doar cu dorinta de a face site-ul mai curat tehnic. Prioritizeaza paginile care pot atrage cerere relevanta, cele care sustin funnel-ul si URL-urile necesare pentru masurarea corecta a conversiilor.
O companie B2B cu un ciclu de vanzare lung poate pune accent pe pagini educative, servicii specializate si resurse care genereaza cereri de oferta. Un ecommerce poate prioritiza categoriile, produsele disponibile, navigarea si paginile de brand. O afacere locala va analiza mai atent paginile de servicii si acoperirea geografica.
Conteaza si capacitatea interna de mentenanta. Daca mai multe agentii, dezvoltatori sau platforme modifica site-ul, este nevoie de responsabilitate clara, versiuni documentate si verificari dupa deploy. Hive Boom ofera servicii SEO care pot include analiza directiei strategice si a problemelor care afecteaza accesibilitatea organica a website-ului.
Ce influenteaza costul unui audit sau al unei corectii robots.txt?
Nu exista un cost standard pentru analiza robots.txt SEO, deoarece complexitatea depinde de website. Pentru un site mic, verificarea poate fi concentrata pe cateva reguli si pagini prioritare. Pentru un ecommerce sau o platforma cu multe integrari, auditul poate implica analiza arhitecturii URL-urilor, parametrilor, sitemap-urilor, indexarii, randarii si a modificarilor tehnice.
Este util sa separi costul serviciului SEO de costurile de dezvoltare. Analiza si recomandarea pot fi realizate in cadrul unei strategii SEO, in timp ce implementarea poate necesita interventia echipei tehnice. Daca sunt necesare instrumente suplimentare, mentenanta sau modificari de platforma, acestea reprezinta componente distincte.
Intrebari frecvente despre robots.txt SEO
Poate robots.txt sa elimine sigur o pagina din Google?
Nu neaparat. Robots.txt limiteaza in principal explorarea URL-ului, dar nu este o metoda completa de eliminare din index. Pentru o pagina care trebuie exclusa din rezultatele de cautare, noindex este de multe ori solutia mai potrivita, daca motorul de cautare poate accesa pagina pentru a citi directiva.
Este rau sa ai un fisier robots.txt gol?
Nu. Un fisier gol sau foarte simplu poate fi suficient pentru un website fara zone tehnice care necesita restrictii. Important este ca paginile publice relevante sa poata fi explorate, iar zonele cu risc de duplicare, date private sau URL-uri inutile sa fie evaluate separat.
Trebuie blocate toate paginile cu parametri?
Nu. Unii parametri pot genera duplicate sau combinatii fara valoare, dar altii pot sustine pagini utile pentru utilizatori sau pentru cautari specifice. Decizia trebuie luata dupa analiza modului in care parametrii afecteaza indexarea, linkurile interne, traficul si structura catalogului.
Cat de des trebuie verificat robots.txt?
Verifica fisierul dupa migrari, redesign, schimbari de CMS, modificari ale structurii URL-urilor si lansari de functii noi. O revizuire periodica este utila si pentru site-urile mari, deoarece reguli vechi pot ramane active dupa ce contextul tehnic sau comercial s-a schimbat.
Poate o eroare robots.txt sa afecteze leadurile?
Poate afecta vizibilitatea paginilor care atrag trafic organic relevant, iar acest lucru poate reduce oportunitatile de conversie. Totusi, leadurile depind si de cererea existenta, oferta, mesaj, formular, viteza site-ului, tracking si modul in care echipa de vanzari raspunde solicitarilor.
Concluzie: foloseste robots.txt ca instrument de control, nu ca solutie universala
O strategie corecta de robots.txt SEO protejeaza accesul crawlerelor la paginile care sustin obiectivele de business si limiteaza explorarea URL-urilor fara utilitate. Cele mai bune decizii pornesc din date despre indexare, trafic, arhitectura site-ului si intentia de cautare. Daca ai dubii dupa o lansare sau o scadere de vizibilitate, Hive Boom poate analiza relatia dintre configuratia tehnica, continut, pagini de conversie si strategia SEO a companiei.
Optimizeaza fundatia tehnica SEO
Descopera cum serviciile SEO Hive Boom pot conecta analiza tehnica, continutul relevant si paginile orientate spre obiective comerciale.
Descopera serviciile SEOAnalizeaza riscurile de indexare
Discuta despre structura website-ului, paginile prioritare si directia SEO potrivita pentru vizibilitate organica sustenabila.
Solicita un auditVerifica daca website-ul tau pierde vizibilitate prin blocaje tehnice
Hive Boom ofera servicii SEO si poate analiza modul in care robots.txt, indexarea, structura URL-urilor si paginile de conversie sustin obiectivele tale de marketing. O discutie strategica ajuta la prioritizarea problemelor cu impact real asupra vizibilitatii si traficului relevant.